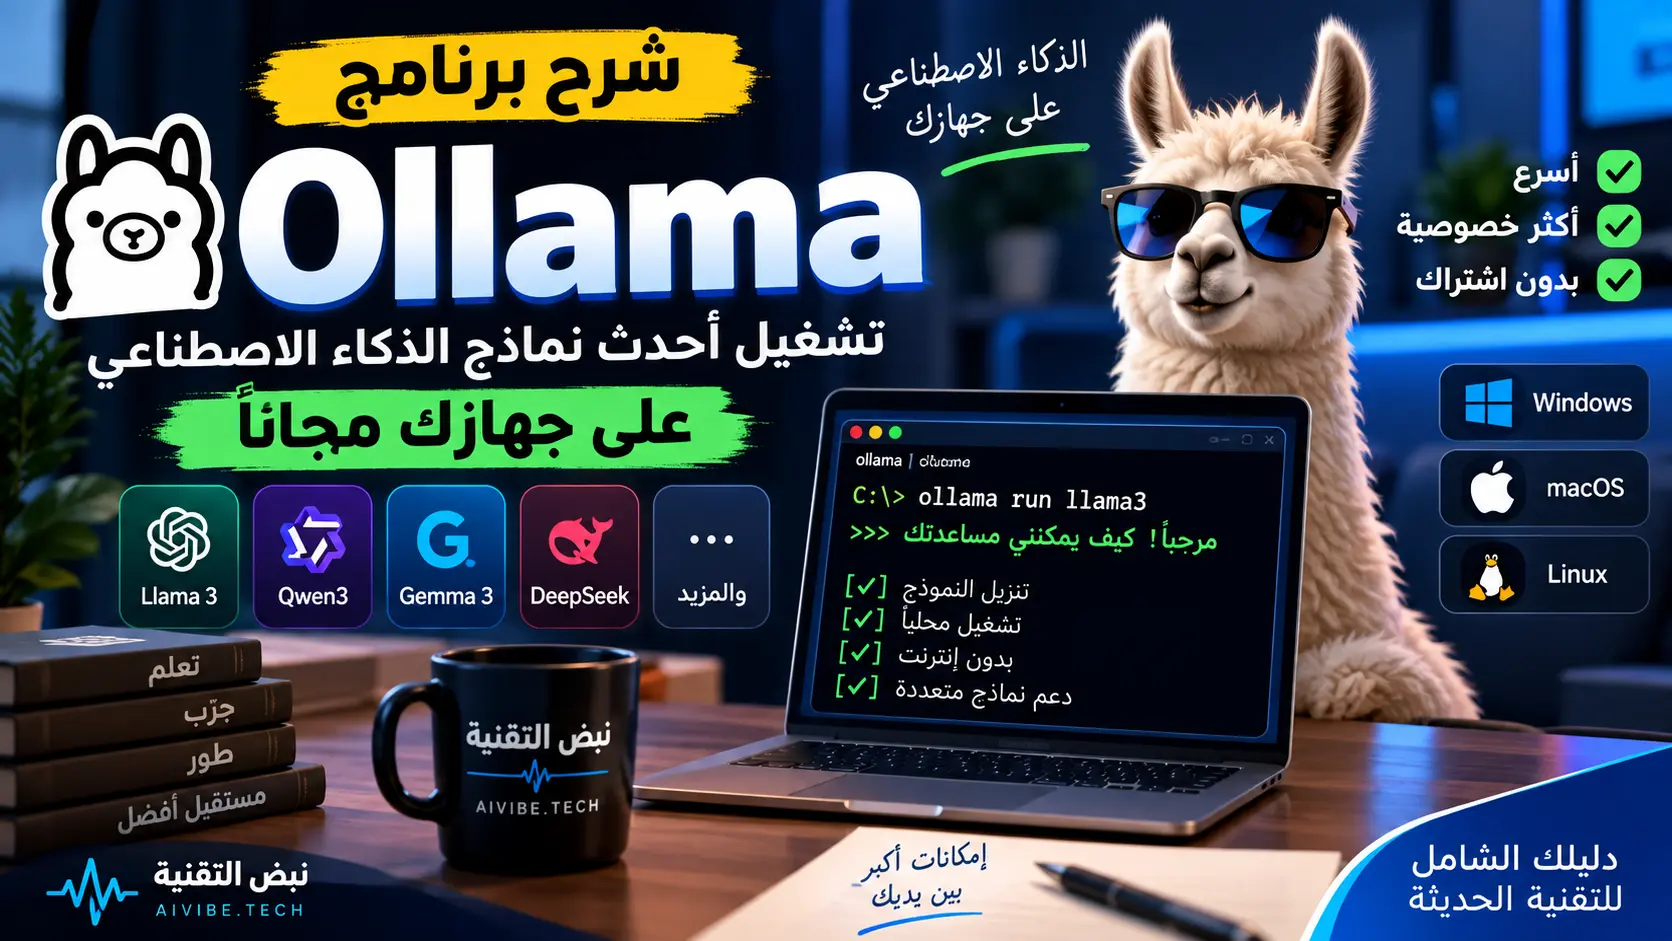

- Ollama يتيح لك تشغيل نماذج ذكاء اصطناعي على الكمبيوتر محليًا بدل إرسال كل طلب إلى خدمة سحابية.
- يتوفر رسميًا لأنظمة Windows وmacOS وLinux، ويمكن تشغيل نماذج صغيرة أو كبيرة حسب إمكانات جهازك.
- للمبتدئ، الأفضل البدء بنموذج خفيف مثل Qwen3 1.7B أو Gemma 3 1B ثم الانتقال إلى نماذج أكبر إذا كان الجهاز يتحملها.
- بعد التثبيت، يمكنك تشغيل نموذج بأمر واحد مثل
ollama run qwen3:1.7b.
إذا كنت تريد تجربة الذكاء الاصطناعي على جهازك بدل الاعتماد دائمًا على ChatGPT أو خدمات سحابية مشابهة، فإن Ollama من أسهل الطرق للبدء. فهو يتولى تحميل النماذج وتشغيلها وإدارتها من خلال أوامر بسيطة، دون الحاجة إلى إعداد بيئة معقدة في كل مرة.
في هذا الدليل من نبض التقنية سنشرح طريقة تثبيت Ollama وتشغيل أول نموذج خطوة بخطوة، وكيف تختار نموذجًا مناسبًا لذاكرة جهازك، بالإضافة إلى أهم الأوامر التي ستحتاجها فعليًا أثناء الاستخدام.
ما هو Ollama؟
Ollama هو برنامج يساعدك على تشغيل نماذج الذكاء الاصطناعي على جهاز الكمبيوتر بطريقة أبسط من تنزيل ملفات النموذج وضبط كل شيء يدويًا. بعد تثبيت البرنامج تستطيع تحميل النموذج وتشغيله من Terminal أو PowerShell باستخدام أوامر قصيرة.
على سبيل المثال، بدل التعامل يدويًا مع ملفات نموذج Qwen وإعداد بيئة تشغيل خاصة به، يمكنك ببساطة كتابة:
ollama run qwen3:1.7bفي أول تشغيل سيقوم Ollama بتنزيل النموذج، وبعد اكتمال التنزيل يمكنك بدء محادثة معه مباشرة من سطر الأوامر.
وإذا كان هدفك الأساسي هو تجربة الذكاء الاصطناعي بدون الاعتماد الدائم على الخدمات السحابية، ففكرة Ollama قريبة من فكرة تشغيل النماذج محليًا على الكمبيوتر، لكنها موجهة بشكل أكبر للمستخدمين والمطورين الذين يريدون سهولة في إدارة أكثر من نموذج.
هل Ollama مجاني؟
يمكن تنزيل Ollama وتشغيل النماذج المحلية المدعومة من خلاله دون دفع مقابل كل رسالة كما يحدث في كثير من خدمات API السحابية. لكن كلمة “مجاني” لا تعني أن جميع النماذج لها نفس الترخيص؛ فترخيص استخدام النموذج نفسه يعتمد على الجهة التي قامت بإصداره.
لذلك من الأفضل دائمًا مراجعة صفحة النموذج في مكتبة Ollama، خصوصًا إذا كنت ستستخدمه في مشروع تجاري أو تطبيق عام.
هناك أيضًا نماذج وخدمات سحابية يمكن استخدامها من منظومة Ollama، ولذلك من المهم التفريق بين تشغيل نموذج محلي على جهازك وبين الخدمات المستضافة على الإنترنت.
متطلبات تشغيل Ollama
لا توجد مواصفات واحدة تناسب جميع النماذج. السبب أن الفرق بين نموذج بحجم مليار معامل ونموذج بعشرات المليارات كبير جدًا من ناحية الذاكرة وسرعة التشغيل.
بصورة عملية، يمكنك استخدام هذا التقريب عند اختيار النموذج الأول:
| حالة الجهاز | نموذج مناسب للبدء | ملاحظة |
|---|---|---|
| جهاز ضعيف أو ذاكرة محدودة | Gemma 3 270M أو 1B | خفيف للتجربة والمهام البسيطة |
| 8GB RAM تقريبًا | Qwen3 1.7B أو نموذج صغير مشابه | أغلق البرامج الثقيلة للحصول على أداء أفضل |
| 16GB RAM أو أكثر | نماذج 4B أو 8B بحسب الجهاز | الأداء يعتمد أيضًا على المعالج وبطاقة الرسوميات |
| جهاز قوي جدًا | نماذج أكبر | تحتاج ذاكرة وتخزينًا أكبر بكثير |
هذه ليست حدودًا رسمية صارمة؛ فحجم الملف، نوع Quantization، طول السياق وطريقة استخدام GPU كلها تؤثر على استهلاك الذاكرة.
لذلك لا تبدأ مباشرة بنموذج 30B أو 70B لمجرد أنه أقوى. في كثير من الاستخدامات اليومية قد يكون نموذج صغير أسرع وأكثر عملية.
طريقة تثبيت Ollama على Windows وmacOS وLinux
تثبيت Ollama على Windows
ادخل إلى صفحة التنزيل الرسمية، اختر Windows ثم ثبّت البرنامج بالطريقة المعتادة. بعد اكتمال التثبيت افتح PowerShell أو موجه الأوامر.
للتأكد من أن Ollama يعمل، اكتب:
ollama --versionالتثبيت على macOS
يمكن تنزيل نسخة macOS من الموقع الرسمي وتثبيتها، ثم فتح Terminal وتشغيل أمر التحقق السابق.
التثبيت على Linux
يوفر Ollama أمر تثبيت رسميًا لنظام Linux:
curl -fsSL https://ollama.com/install.sh | shبعد ذلك تحقق من التثبيت باستخدام:
ollama --versionكيف تشغل أول نموذج ذكاء اصطناعي باستخدام Ollama؟
بعد التأكد من نجاح التثبيت، تأتي الخطوة الممتعة: تشغيل نموذج فعلي.
إذا كان جهازك متوسطًا أو محدود الموارد، يمكنك البدء مثلًا بـ:
ollama run qwen3:1.7bسيقوم Ollama بتنزيل ملفات النموذج تلقائيًا في أول مرة. بعد ذلك ستظهر لك واجهة محادثة داخل الطرفية ويمكنك كتابة سؤالك مباشرة.
مثال:
اكتب لي ملخصًا بسيطًا عن الحوسبة السحابية.للخروج من جلسة النموذج يمكنك عادةً استخدام:
/byeما أفضل نماذج Ollama للمبتدئين؟
مكتبة Ollama كبيرة، ولا يوجد نموذج واحد هو الأفضل للجميع. الاختيار يعتمد على الجهاز ونوع المهمة.
Qwen3
عائلة Qwen3 متاحة بأحجام متعددة تبدأ من نماذج صغيرة مثل 0.6B و1.7B وتصل إلى أحجام كبيرة جدًا. وهذا يجعلها مناسبة للتجربة لأنك تستطيع اختيار إصدار قريب من قدرات جهازك.
لتشغيل نسخة 1.7B:
ollama run qwen3:1.7bGemma 3
Gemma 3 من Google متوفر أيضًا بأحجام مختلفة، ومنها 270M و1B و4B و12B و27B. النسخ الصغيرة مناسبة عندما تريد اختبار Ollama دون تحميل نموذج ضخم.
مثال:
ollama run gemma3:1bإذا وجدت أن الاستجابة بطيئة جدًا، لا تفترض أن المشكلة من Ollama نفسه. جرّب أولًا نموذجًا أصغر ثم قارن الأداء.
أهم أوامر Ollama التي ستحتاجها
عرض النماذج الموجودة على جهازك
ollama listتنزيل نموذج
ollama pull qwen3:1.7bتشغيل نموذج
ollama run qwen3:1.7bحذف نموذج لا تحتاجه
ollama rm qwen3:1.7bهذا الأمر مفيد جدًا لأن ملفات النماذج يمكن أن تستهلك عدة جيجابايت من مساحة القرص.
هل يمكن استخدام Ollama داخل التطبيقات؟
نعم. هذه إحدى أهم نقاط قوة Ollama بالنسبة للمطورين؛ فهو يوفر API محلية يمكن للتطبيقات والبرامج إرسال الطلبات إليها.
من الأمثلة الأساسية إرسال طلب إلى واجهة الدردشة المحلية:
curl http://localhost:11434/api/chat \
-d '{
  "model": "qwen3:1.7b",
  "messages": [
    {
      "role": "user",
      "content": "اشرح الذكاء الاصطناعي ببساطة"
    }
  ],
  "stream": false
}'
هذه الميزة تتيح لك بناء تطبيقات تستفيد من نموذج يعمل على جهازك بدل الاعتماد دائمًا على API خارجية.
إذا كان اهتمامك الأساسي هو البرمجة واستخدام مساعد ذكاء اصطناعي أثناء تطوير المشاريع، يمكنك أيضًا الاطلاع على دليلنا عن
MiniMax Code 2.0 وأدوات الذكاء الاصطناعي للبرمجة.
هل Ollama يحتاج إلى الإنترنت؟
تحتاج إلى الإنترنت عند تثبيت البرنامج وتنزيل النموذج لأول مرة. بعد وجود النموذج على جهازك، يمكن تنفيذ كثير من عمليات الاستدلال محليًا دون إرسال كل Prompt إلى خدمة خارجية.
لكن يجب الانتباه إلى أن البرنامج أو التطبيقات التي تربطها بـ Ollama قد تستخدم الإنترنت لأسباب أخرى، لذلك لا يكفي تشغيل نموذج محلي وحده لضمان أن كل برنامج تستخدمه يعمل Offline بالكامل.
هل Ollama أفضل للخصوصية؟
من أكبر فوائد التشغيل المحلي أنك تستطيع معالجة الكثير من النصوص على جهازك بدل إرسالها إلى مزود نموذج خارجي في كل مرة.
لكن الخصوصية لا تعتمد على Ollama وحده. إذا ربطت النموذج بتطبيق خارجي أو إضافة متصفح أو خدمة أخرى، يجب مراجعة ما تقوم به تلك الأداة أيضًا.
لا تدخل كلمات مرور أو مفاتيح API أو معلومات حساسة في أدوات أو واجهات غير موثوقة لمجرد أن النموذج الأساسي يعمل محليًا.
Ollama أم الخدمات السحابية؟
| المقارنة | Ollama محليًا | خدمة سحابية |
|---|---|---|
| الخصوصية | الاستدلال يمكن أن يتم على جهازك | الطلبات ترسل عادة إلى خوادم المزود |
| قوة الجهاز | مهمة جدًا | أقل أهمية للمستخدم |
| العمل بدون إنترنت | ممكن بعد تنزيل النموذج في حالات كثيرة | غالبًا غير ممكن |
| النماذج الكبيرة | قد تحتاج جهازًا قويًا جدًا | الخادم يتحمل العبء |
حل أشهر مشاكل Ollama
النموذج بطيء جدًا
أول شيء جرّبه هو نموذج أصغر. الانتقال من نموذج 8B إلى 1B أو 1.7B قد يحدث فرقًا كبيرًا على الأجهزة المتوسطة.
كما يساعد إغلاق البرامج التي تستهلك RAM بكثرة، خصوصًا المتصفح إذا كان يحتوي على عدد كبير من التبويبات.
مساحة القرص تنخفض بسرعة
النماذج ليست ملفات صغيرة. بعض النسخ تحتاج مئات الميجابايت، وأخرى عدة جيجابايت أو أكثر. استخدم:
ollama listلمعرفة النماذج الموجودة، ثم احذف ما لا تحتاج إليه باستخدام:
ollama rm اسم-النموذجظهور خطأ عند كتابة ollama
إذا ظهر أن الأمر غير معروف بعد التثبيت، أغلق Terminal أو PowerShell وافتحه من جديد. وإذا استمرت المشكلة، تحقق من اكتمال التثبيت أو أعد تشغيل الكمبيوتر.
لا أعرف أي نموذج أختار
ابدأ بالأصغر. هذه أفضل نصيحة للمبتدئ. جرّب نموذجًا بين 1B و4B أولًا، ثم انتقل إلى حجم أكبر فقط إذا كنت تحتاج جودة أعلى وكان الأداء جيدًا.
هل يمكن استخدام Ollama لتوليد الصور؟
Ollama مشهور أساسًا بتشغيل نماذج اللغة والنماذج المتوافقة الموجودة في مكتبته. إذا كان هدفك الأساسي هو إنشاء الصور بالذكاء الاصطناعي، فمن الأفضل استخدام أدوات ونماذج مخصصة لذلك.
للتعرف على أحد أشهر الخيارات يمكنك قراءة:
شرح FLUX AI لتوليد الصور للمبتدئين.
الأسئلة الشائعة حول Ollama
هل Ollama مجاني تمامًا؟
تشغيل Ollama والنماذج المحلية لا يعتمد على الدفع مقابل كل رسالة، لكن يجب مراجعة ترخيص كل نموذج والخدمات الإضافية التي تستخدمها.
هل يمكن تشغيل Ollama بدون كرت شاشة؟
يمكن تشغيل بعض النماذج باستخدام المعالج والذاكرة الرئيسية، لكن السرعة تختلف بشدة حسب النموذج والجهاز. وجود GPU مناسب يمكن أن يحسن الأداء في حالات كثيرة.
هل 8GB RAM تكفي لـ Ollama؟
تكفي لتجربة عدد من النماذج الصغيرة، لكنها ليست مناسبة لكل النماذج. ابدأ مثلًا بنموذج 1B أو 1.7B بدل نموذج كبير.
هل يمكن تشغيل نموذج 70B على كمبيوتر عادي؟
في معظم أجهزة المستخدمين العادية سيكون تشغيل نموذج بهذا الحجم غير عملي بسبب الذاكرة والموارد المطلوبة. اختر نموذجًا أصغر يناسب جهازك بدل التركيز على عدد المعاملات فقط.
أين أجد نماذج Ollama؟
توجد مكتبة رسمية للنماذج على موقع Ollama ويمكنك من خلالها مشاهدة أسماء النماذج والأحجام المختلفة وأمر التشغيل لكل نموذج.
الخلاصة
إذا كانت هذه أول تجربة لك مع الذكاء الاصطناعي المحلي، فلا تبدأ بأقوى نموذج تجده. ثبت Ollama، اختر نموذجًا صغيرًا يناسب جهازك، وشغله بالأمر البسيط ollama run. إذا أعجبتك التجربة وكان الجهاز يعمل بسلاسة، انتقل تدريجيًا إلى نموذج أكبر.
الميزة الحقيقية في Ollama ليست مجرد تشغيل نموذج بدون متصفح؛ بل أنه يمنحك طريقة موحدة لتنزيل النماذج وإدارتها وربطها بالتطبيقات المحلية بسهولة أكبر.
أما إذا كان استخدامك الأساسي للذكاء الاصطناعي هو التعامل مع المستندات بدل تشغيل النماذج بنفسك، فقد يفيدك أيضًا دليل
أفضل أدوات الذكاء الاصطناعي لتحليل وتلخيص ملفات PDF بالعربي.