
جربت تشغيل الذكاء الاصطناعي على أندرويد بدون إنترنت باستخدام AnythingLLM ونموذج Qwen3.5 4B. بعد تنزيل النموذج بحجم 3.79 GB، فصلت الإنترنت وأرسلت له سؤالًا جديدًا بالعربية، واستطاع إكمال الإجابة محليًا. التجربة نجحت في المحادثة النصية، لكنني واجهت مشكلة عند اختبار ملف PDF، كما أن سرعة الرد كانت أبطأ بوضوح من الخدمات السحابية.
لم أكتب هذا المقال اعتمادًا على قائمة مميزات التطبيق. استخدمت AnythingLLM بنفسي، التقطت صورًا أثناء الاختبار وسجلت أوقات الإجابات. بعض النتائج أعجبتني فعلًا، وبعضها لم يعمل كما توقعت. لذلك ستجد هنا ما حدث معي كما هو، بما في ذلك الخطأ الذي ظهر أثناء تجربة المستندات.
استطاع Qwen3.5 4B فهم العربية والعمل بدون إنترنت بعد تنزيله على الهاتف. سجلت حوالي 54.2 ثانية في أحد اختبارات العربية و52.1 ثانية في اختبار آخر. أما ملف PDF فلم يعمل لدي بصورة مستقرة وظهر خطأ
Invalid vector schema في إحدى المحاولات. دعم الصور ظهر أيضًا داخل التطبيق، لكنه احتاج تنزيلًا إضافيًا بحجم 672.42 MB، لذلك لم أختبره بالكامل في هذه الجولة.ماذا اختبرت بالضبط؟
كان لدي سؤال بسيط قبل بدء التجربة: هل أصبح من الممكن فعلًا وضع نموذج ذكاء اصطناعي على هاتف أندرويد، إغلاق الإنترنت، ثم التحدث معه بالعربية بشكل مفيد؟
لذلك لم أرد الاكتفاء بفتح التطبيق وإرسال سؤال واحد. قسمت التجربة إلى عدة مراحل: تنزيل النموذج المحلي، اختبار اللغة العربية، فصل الإنترنت، قياس وقت بعض الردود، تجربة إرفاق ملف PDF، ثم التحقق من الخيارات المتاحة للصور.
هذا التفصيل مهم لأن عبارة «يعمل بدون إنترنت» قد تكون مضللة أحيانًا. قد يعمل النموذج نفسه محليًا بينما تحتاج ميزة أخرى داخل التطبيق إلى الإنترنت. وهذا بالفعل أحد الأشياء التي ظهرت لي أثناء التجربة.
ما هو AnythingLLM؟
AnythingLLM تطبيق ومنصة تسمح باستخدام نماذج ذكاء اصطناعي مختلفة والتعامل معها من خلال المحادثات والمستندات وأدوات إضافية. وما جذبني في نسخة أندرويد تحديدًا هو إمكانية تنزيل نموذج صغير وتشغيله محليًا على الهاتف.
الفكرة تختلف عن الطريقة المعتادة في تطبيقات الذكاء الاصطناعي السحابية. في الاستخدام السحابي ترسل طلبك عبر الإنترنت إلى خوادم تشغّل النموذج ثم تستقبل الإجابة. أما عند تشغيل نموذج محلي، فملفات النموذج موجودة على جهازك وتتم عملية الاستدلال محليًا عندما تستخدم ذلك النموذج.
إذا كانت فكرة تشغيل النماذج محليًا تهمك ولكنك تريد تجربتها على الكمبيوتر أيضًا، فقد شرحت سابقًا طريقة تشغيل الذكاء الاصطناعي بدون إنترنت باستخدام Jan AI. الفرق هنا أنني أردت معرفة إلى أي مدى أصبحت التجربة عملية على هاتف أندرويد نفسه.
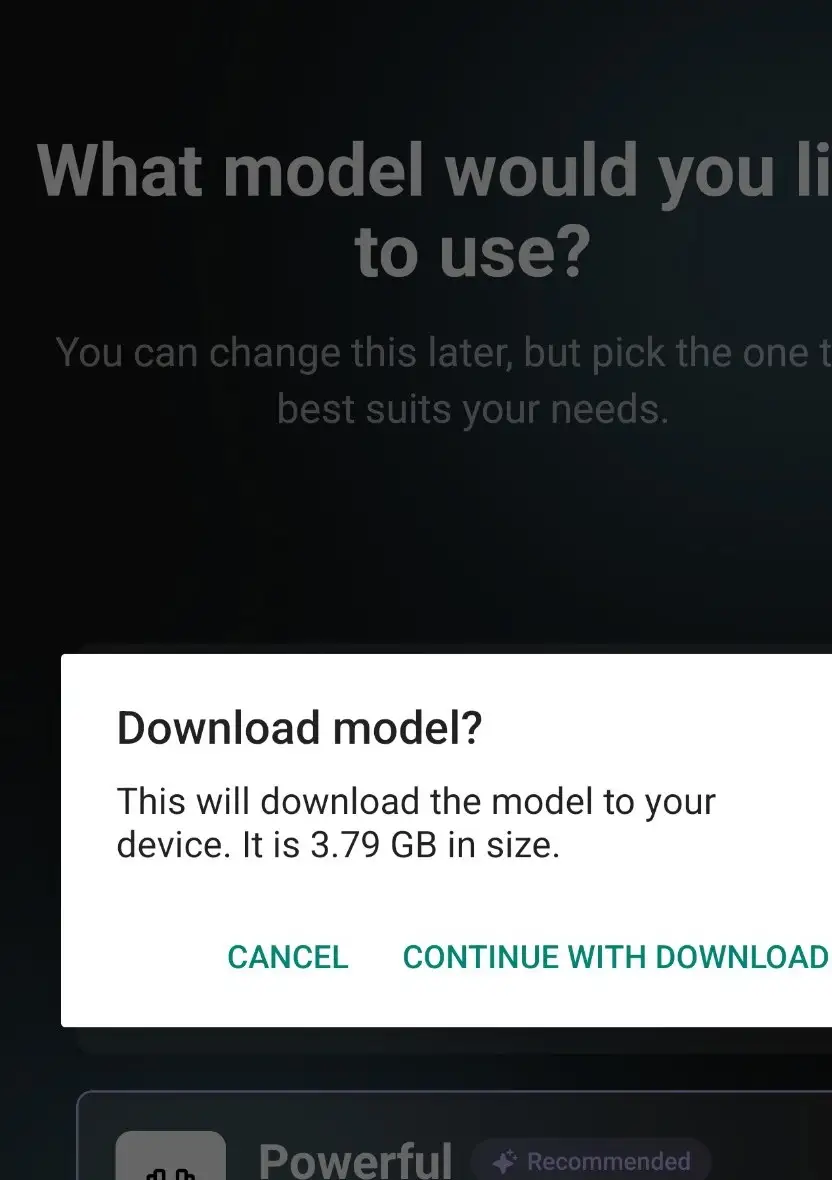
اختيار Powerful وتنزيل نموذج بحجم 3.79 GB
في بداية إعداد AnythingLLM ظهرت لي عدة اختيارات لمستوى النموذج. كان هناك خيار أخف، وخيارات أخرى، ثم Powerful. اخترت Powerful لأنني أردت اختبار أفضل تجربة محلية يعرضها التطبيق لي بدل البدء بأخف نموذج ثم الحكم على جودة AnythingLLM من خلاله.
بعد الاختيار ظهرت أول مفاجأة: التطبيق طلب تنزيل ملف بحجم 3.79 GB.
هذه ليست مساحة صغيرة، خصوصًا إذا كان الهاتف ممتلئًا أصلًا بالصور والألعاب. كما اكتشفت لاحقًا أن بعض الإمكانات يمكن أن تتطلب تنزيل ملفات إضافية، لذلك من الأفضل توفير مساحة أكبر من حجم النموذج نفسه قبل البدء.
انتظرت حتى انتهى التنزيل، وبعد فتح المحادثة ظهر أن النموذج الذي حصلت عليه هو Qwen3.5 4B.
ما هو Qwen3.5 4B؟
Qwen عائلة من نماذج الذكاء الاصطناعي، أما الرقم 4B فيشير إلى فئة نموذج بحوالي أربعة مليارات من المعاملات. هذا الحجم أصغر بكثير من النماذج السحابية الضخمة، وهذا جزء مما يجعل تشغيله محليًا على أجهزة أصغر ممكنًا.
لكن عدد المعاملات وحده لا يخبرك بجودة النموذج. طريقة التدريب والبنية والكمّية المستخدمة في النموذج وطبيعة المهمة كلها تؤثر على النتيجة. لهذا السبب لم أرد تقييم Qwen3.5 4B من اسمه أو مواصفاته فقط؛ الاختبار بالعربية كان أهم بالنسبة لي.
هل Qwen3.5 4B يفهم اللغة العربية؟
نعم، في تجربتي فهم Qwen3.5 4B العربية واستطاع كتابة إجابة عربية منظمة ومفهومة. لم أجد واجهة عربية لـAnythingLLM في النسخة التي استخدمتها، لكن لغة الواجهة لا تمنع النموذج من استقبال الأسئلة العربية.
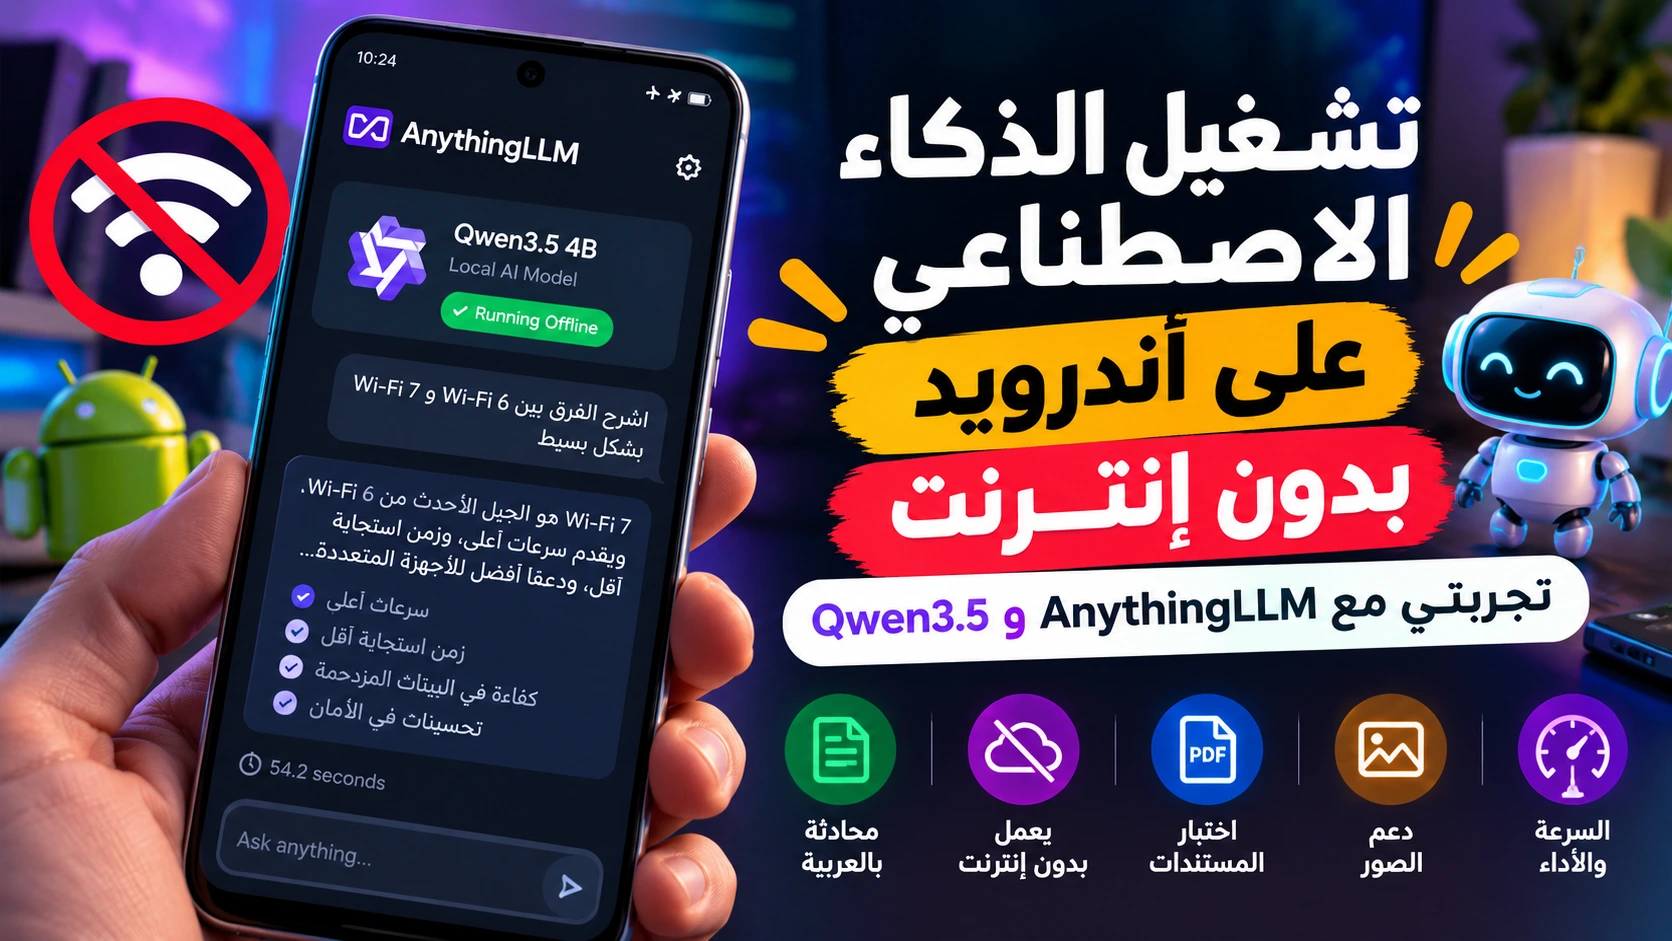
بدأت بسؤال تقني بسيط نسبيًا: طلبت منه شرح الفرق بين Wi-Fi 6 وWi-Fi 7 بطريقة سهلة مع ذكر أهم الفروق. أردت سؤالًا يتطلب شرحًا وليس مجرد ترجمة كلمة أو إجابة بنعم أو لا.
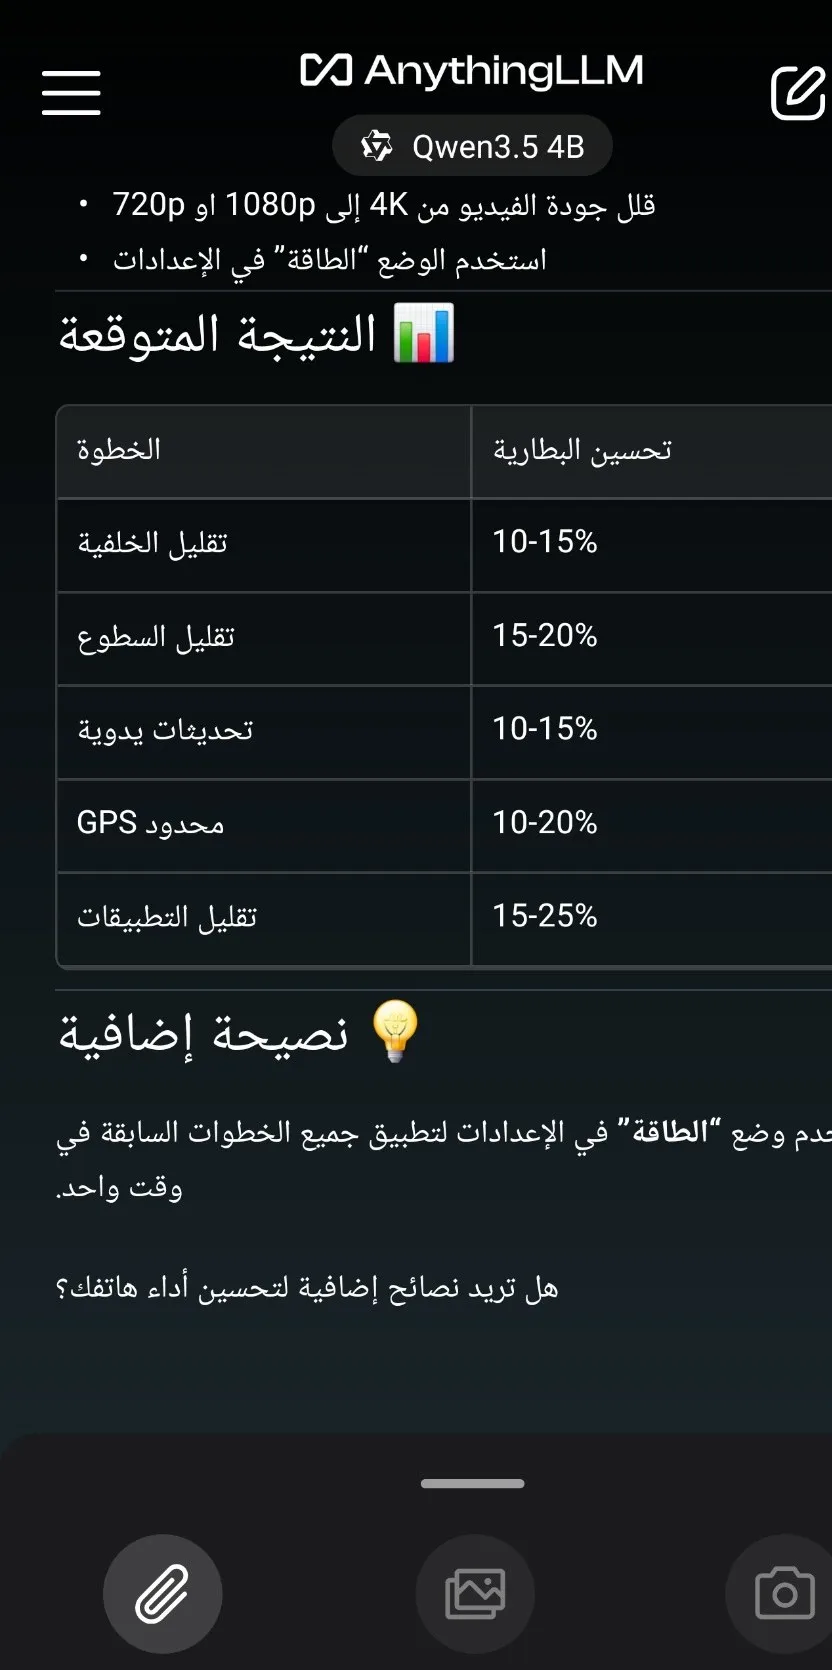
الإجابة من ناحية الأسلوب كانت أفضل مما توقعت من نموذج يعمل على الهاتف. فهم السؤال، حافظ على العربية وقدم نقاطًا مرتبة بدل نص مشوش.
لكنني لاحظت شيئًا يستحق التنبيه: بعض التفاصيل التقنية والأرقام التي يمكن أن يقدمها نموذج صغير تحتاج إلى مراجعة. لذلك لا أتعامل مع جودة الصياغة على أنها دليل على صحة كل معلومة. هذه قاعدة جيدة سواء كنت تستخدم نموذجًا محليًا أو سحابيًا.
كم استغرق الرد بالعربية؟
في هذا الاختبار ظهر داخل التطبيق أن النموذج عمل لمدة 54.2 ثانية. لم أحاول إخفاء هذا الرقم لأنه من أهم الفروق العملية بين استخدام نموذج على الهاتف وخدمة تعتمد على خوادم قوية.
قرابة دقيقة لإجابة واحدة قد تبدو طويلة لمن اعتاد على الخدمات السحابية. من ناحية أخرى، كنت أشاهد نموذجًا موجودًا على الهاتف نفسه ينفذ المهمة، ولذلك كنت مهتمًا أكثر بإثبات إمكانية التشغيل المحلي في البداية من الوصول إلى أعلى سرعة.
ويجب عدم اعتبار 54.2 ثانية Benchmark رسميًا لـQwen3.5 4B. هذا رقم ظهر في تجربتي، وقد تختلف النتيجة باختلاف الهاتف وطول السؤال والإجابة والذاكرة والحرارة والإعدادات.
الاختبار الحاسم: فصل الإنترنت بالكامل
حتى هذه اللحظة كان يمكن لأي شخص أن يسأل: كيف تعرف أن النموذج لا يزال يعتمد على الإنترنت؟ لذلك كان الاختبار التالي هو الأهم.
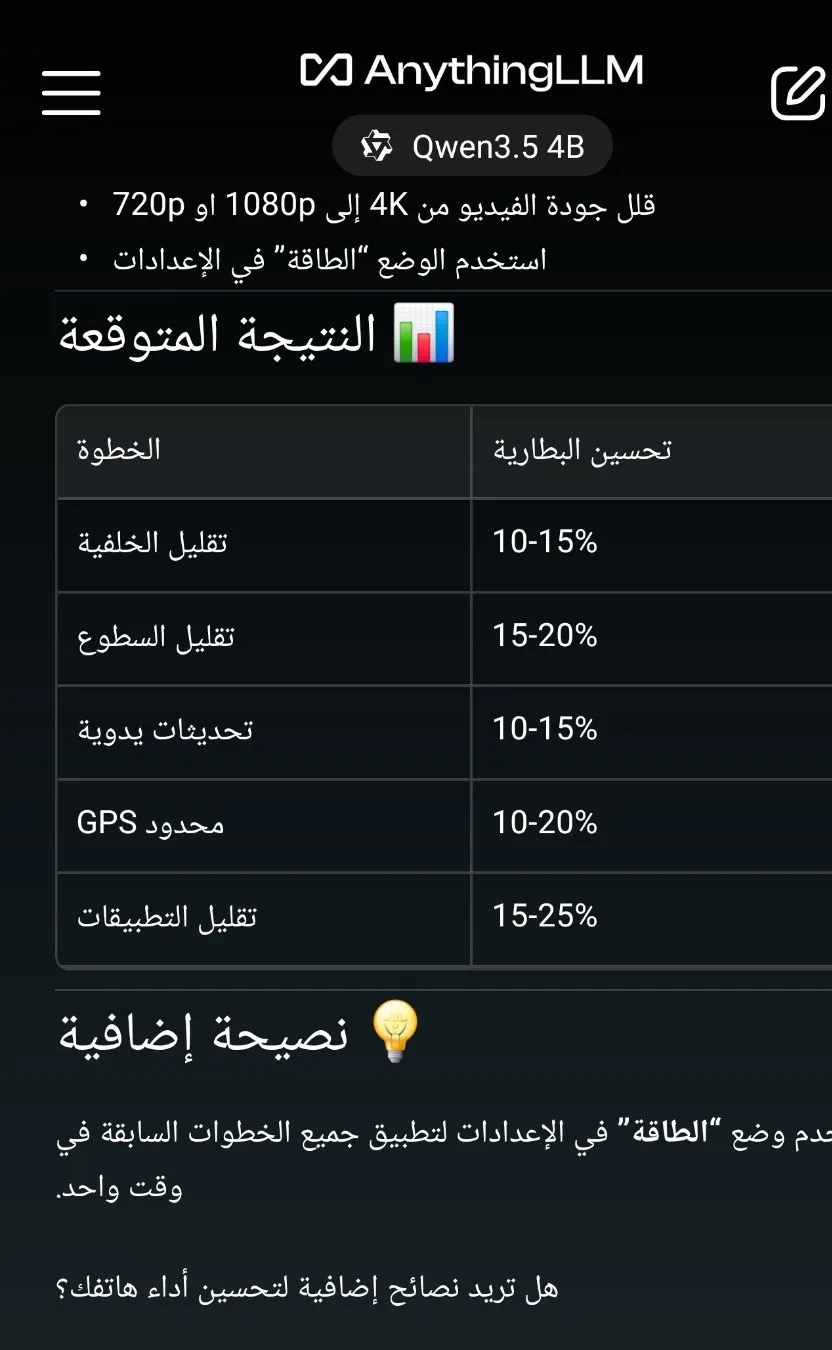
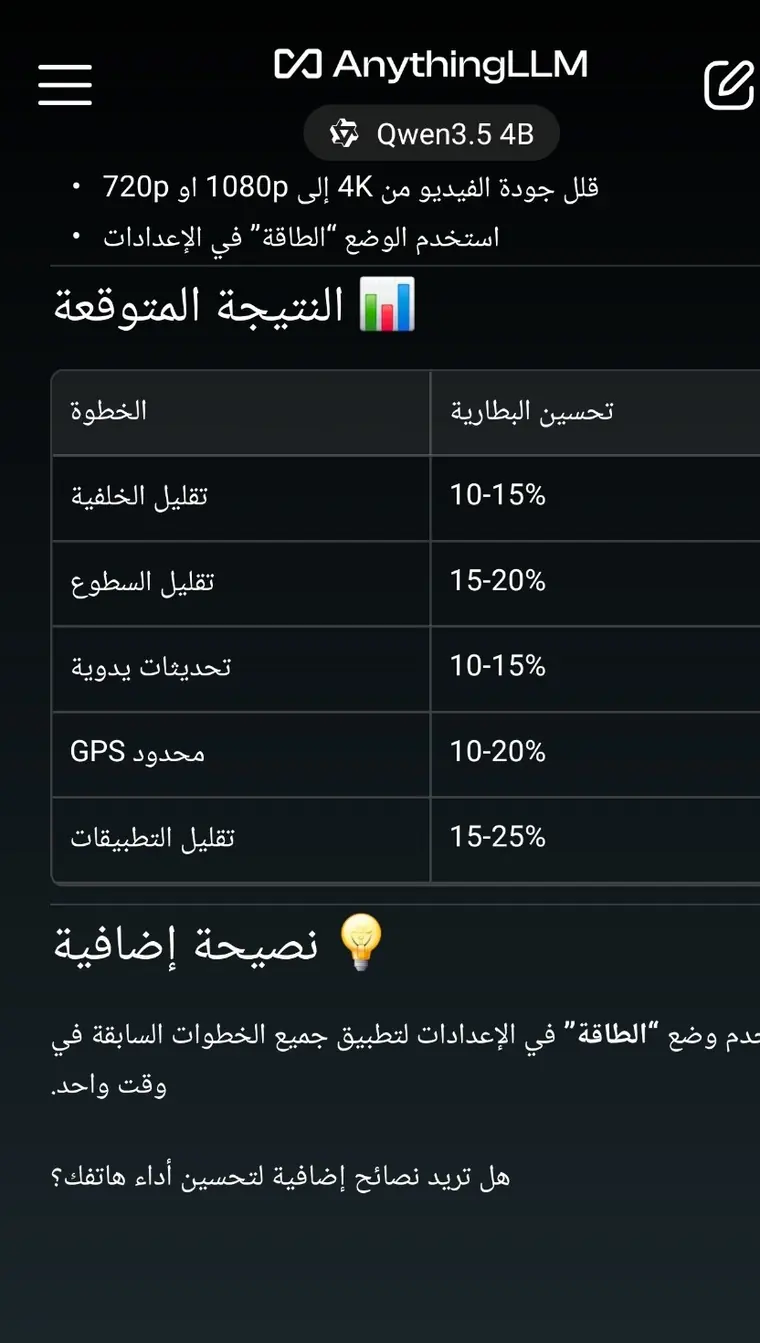
أوقفت الاتصال ثم أرسلت سؤالًا جديدًا مختلفًا عن السؤال الأول. طلبت خمس خطوات لتحسين عمر بطارية هاتف أندرويد مع شرح سبب كل خطوة.
النموذج أجاب.
لم يكن مجرد فتح محادثة قديمة أو قراءة رد محفوظ؛ أرسلت طلبًا جديدًا وحصلت على إجابة جديدة باللغة العربية بعد تنزيل النموذج مسبقًا.
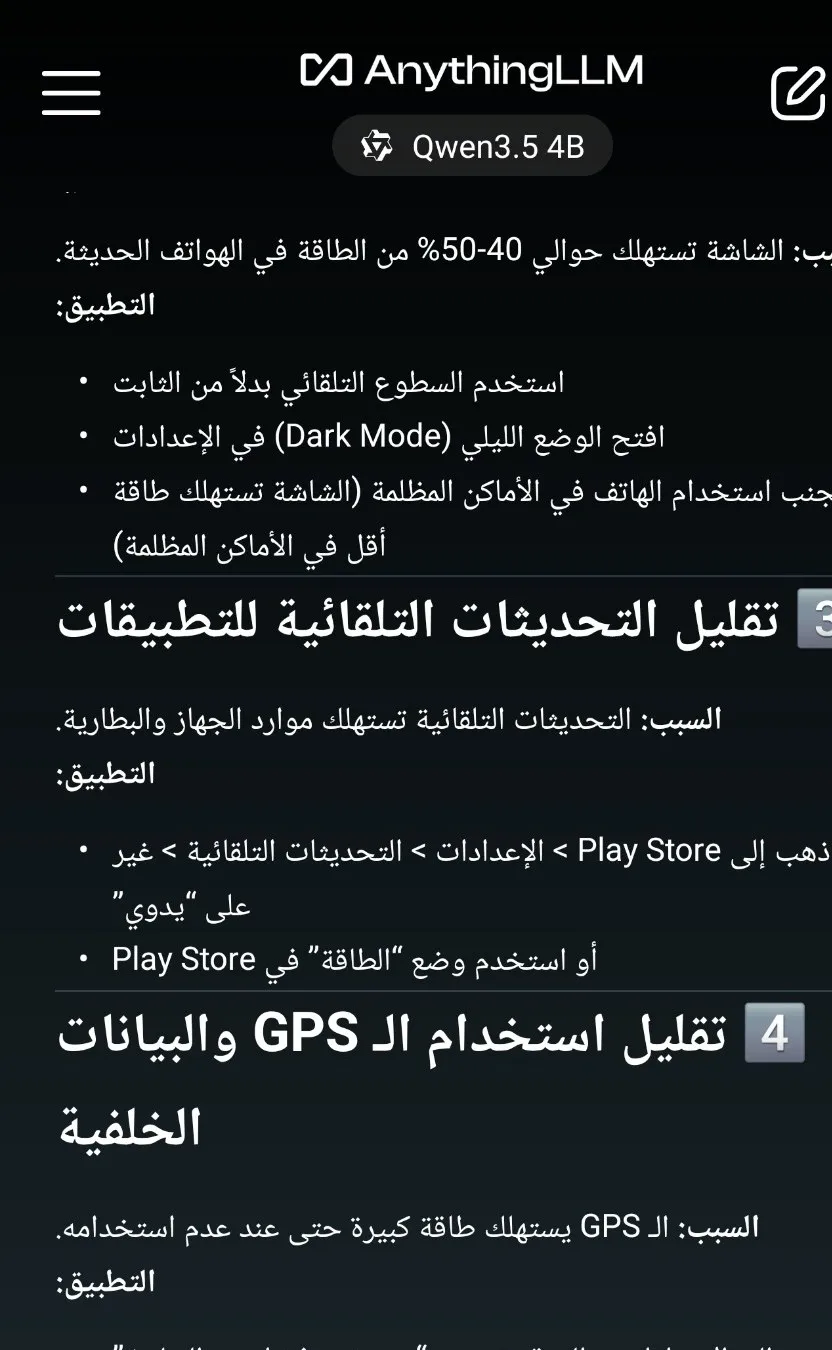
هذه المرة ظهر وقت يقارب 52.1 ثانية. وبالنسبة لي، هذه كانت أهم نتيجة في التجربة كلها: المحادثة النصية مع النموذج المحلي استمرت بدون اتصال بالإنترنت.
هل AnythingLLM يعمل بدون إنترنت إذن؟
المحادثة مع النموذج المحلي عملت بدون إنترنت في اختباري بعد تنزيل النموذج مسبقًا. لكن لا ينبغي توسيع هذه النتيجة والقول إن كل شيء داخل AnythingLLM يعمل Offline.
تنزيل النموذج لأول مرة يحتاج إلى اتصال. البحث في الإنترنت يحتاج اتصالًا بطبيعته. استخدام مزود نموذج خارجي سيختلف عن استخدام Qwen3.5 4B المحلي. كما أن اختبار المستندات الذي سأشرحه بعد قليل كشف أن هناك أجزاء أكثر تعقيدًا من مجرد المحادثة النصية.
لذلك العبارة الأدق من تجربتي هي: يمكن استخدام Qwen3.5 4B في AnythingLLM لإجراء محادثة نصية محلية بدون إنترنت بعد تنزيل النموذج.
لماذا تشغيل AI محليًا مهم أصلًا؟
هناك أكثر من سبب. الأول واضح: إمكانية الاستخدام في مكان لا يوجد فيه اتصال جيد. قد تكون في سفر، أو لديك اتصال ضعيف، أو تريد ببساطة أداة لا تتوقف كلما انقطع الإنترنت.
السبب الثاني يتعلق بالخصوصية. عندما يتم توليد الإجابة بواسطة نموذج يعمل على الجهاز، لا تحتاج عملية الاستدلال نفسها إلى إرسال كل سؤال إلى نموذج سحابي. لكن يجب توخي الدقة هنا: هذا لا يعني تلقائيًا أن كل ميزة في التطبيق لا تتصل بالإنترنت.
إذا استخدمت بحث الويب أو نموذجًا خارجيًا أو تكاملًا مع خدمة أخرى، فمن الطبيعي أن تدخل خدمات خارجية في العملية. لذلك من الأفضل التفكير في الخصوصية على مستوى الميزة التي تستخدمها، لا على مستوى اسم التطبيق فقط.
أما السبب الثالث فهو الفضول التقني. قبل سنوات قليلة كان تشغيل نموذج لغوي مفيد على الهاتف نفسه يبدو أقل عملية بكثير. الآن أصبح بإمكاني تنزيل نموذج، إغلاق الشبكة وطرح سؤال عربي عليه. هذه النقلة بحد ذاتها مثيرة للاهتمام.
الذكاء الاصطناعي المحلي مقابل الذكاء الاصطناعي السحابي
| العامل | AI محلي على الهاتف | AI سحابي |
|---|---|---|
| الإنترنت | يمكن أن يعمل Offline بعد تنزيل النموذج | يحتاج عادة إلى الاتصال بالخدمة |
| مكان تشغيل النموذج | على جهازك | على خوادم بعيدة |
| السرعة | تعتمد على عتاد الهاتف | تستفيد من عتاد خوادم أقوى |
| المساحة | تحتاج إلى تخزين النموذج محليًا | لا تخزن النموذج كاملًا على الهاتف عادة |
| حجم النماذج الممكنة | محدود بإمكانات الجهاز | يمكن تشغيل نماذج أكبر بكثير |
| الخصوصية | يمكن إبقاء الاستدلال المحلي على الجهاز | الطلب يعالج وفق نظام وسياسة الخدمة الخارجية |
بعد التجربة لا أرى المحلي بديلًا كاملًا للسحابي، ولا العكس. أحيانًا أريد أقوى نموذج متاح ولا يهمني وجود الإنترنت، وأحيانًا أريد نموذجًا صغيرًا يعمل على جهازي. وجود الخيارين هو الأهم.
هل سرعة Qwen3.5 4B على الهاتف جيدة؟
إذا كان معيارك هو سرعة خدمات الذكاء الاصطناعي السحابية الحديثة، فالتجربة المحلية التي حصلت عليها كانت أبطأ. سجلت 54.2 ثانية في اختبار و52.1 ثانية في آخر.
وفي محاولة مرتبطة بالمستندات شاهدت أوقاتًا أطول. لذلك لن أصف التجربة بأنها فورية.
في المقابل، لا أريد إعطاء انطباع بأن كل مستخدم سينتظر المدة نفسها. تشغيل نموذج محلي يتأثر بقدرة الجهاز وحالة الذاكرة وحرارة الهاتف وطول السياق والنموذج المستخدم. إذا اخترت نموذجًا أخف، قد تحصل على تجربة مختلفة تمامًا.
المساحة المطلوبة أكبر من مجرد تثبيت التطبيق
هذه نقطة قد يفوتها البعض عند البحث عن «ذكاء اصطناعي بدون إنترنت». التطبيق نفسه ليس الجزء الأكبر بالضرورة؛ النموذج هو الذي يأخذ مساحة كبيرة.
في اختباري كان تنزيل Powerful بحجم 3.79 GB. وبعد ذلك، عندما فتحت خيارات الصور، اكتشفت وجود تنزيل آخر للرؤية حجمه 672.42 MB.
أي أن من يريد تجربة أكثر من ميزة يجب ألا يحسب مساحة التطبيق فقط. وإذا كنت تحتفظ بأكثر من نموذج، فمن الطبيعي أن تزداد المساحة المطلوبة أكثر.
ماذا وجدت عند تجربة الصور؟
عند الضغط على زر الإضافة ظهر لي:
- Attach files
- Gallery
- Take photo
وعند الوصول إلى إمكانات الرؤية ظهر طلب لتنزيل مكون إضافي بحجم 672.42 MB.
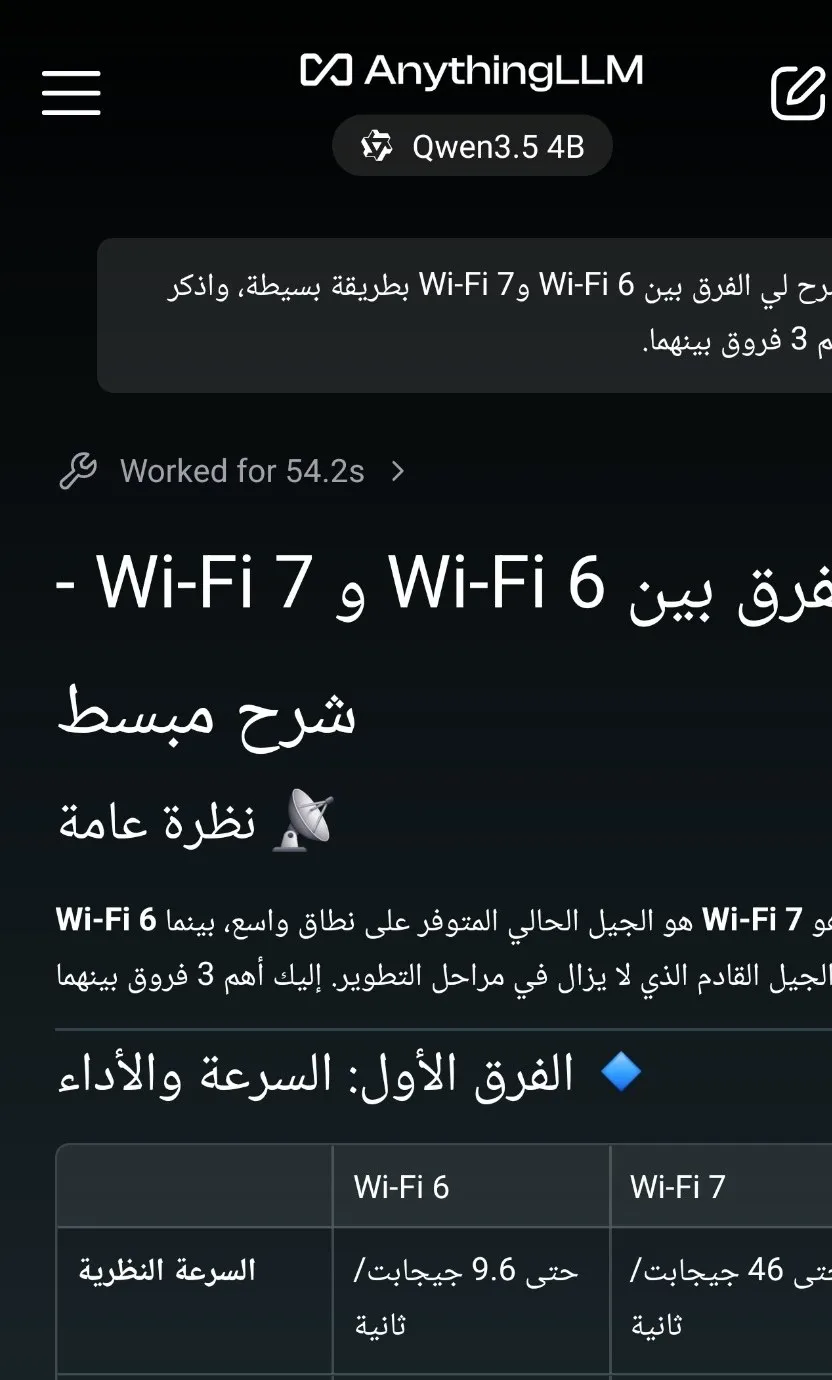
توقفت هنا ولم أنزّل مكون الرؤية في هذه الجولة. أفضل أن أكتب «لم أختبرها» على أن أصف جودة تحليل الصور اعتمادًا على مواصفات التطبيق فقط.
وقد أعود لهذه الجزئية في تحديث لاحق وأختبر صورة حقيقية بالعربية والإنجليزية لمعرفة مدى جودة النموذج في فهم الصور على الهاتف.
تجربة قراءة PDF: اختبار أصعب من الدردشة
بعد أن تأكدت من المحادثة المحلية، أردت تجربة شيء يصعب على النموذج تخمينه.
أنشأت ملف PDF تجريبيًا يحتوي على اسم مشروع ورمز ومعلومات مختلقة خصيصًا للاختبار. الفكرة كانت أن أسأله عن معلومة لا توجد في معرفته السابقة؛ فإذا أعطاني القيمة الصحيحة فهذا دليل على أنه قرأ الملف.
اخترت Attach files ثم أرفقت ملف PDF.
هنا لم تكن النتيجة مثل المحادثة العادية. في إحدى المحاولات ظهرت رسالة الخطأ:
Invalid vector schema
شغلت الإنترنت وأعدت المحاولة. وصل الملف إلى مرحلة المعالجة، لكن عندما اختبرت استخراج المعلومات لم أحصل على نتيجة مستقرة تجعلني أعتبر الاختبار ناجحًا.
وهنا تغير انطباعي قليلًا. المحادثة المحلية كانت سهلة نسبيًا: نزّل النموذج واسأله. التعامل مع المستندات يتضمن خطوات إضافية لمعالجة المحتوى والبحث فيه، ولذلك توجد نقاط أخرى يمكن أن تفشل.
هل يعني ذلك أن AnythingLLM لا يستطيع قراءة PDF؟
لا. هذه ليست النتيجة التي توصلت إليها.
AnythingLLM يقدم أصلًا إمكانات للمحادثة مع المستندات. ما أستطيع إثباته فقط هو أن اختبار PDF على إعداداتي لم يعمل بصورة مستقرة وظهر لي خطأ Invalid vector schema في إحدى المحاولات.
قد يكون السبب إصدار التطبيق، أو معالجة المستند، أو إعدادًا متعلقًا بقاعدة المتجهات، أو شيئًا آخر. لذلك لا أريد تحويل مشكلة حدثت على جهاز واحد إلى حكم عام على الميزة.
وفي الوقت نفسه، لن أخفي المشكلة وأكتب أن PDF عمل بصورة ممتازة، لأن هذا لم يحدث معي.
نتائج تجربتي في جدول واحد
| ما اختبرته | النتيجة | التفاصيل |
|---|---|---|
| تنزيل نموذج محلي | نجح | 3.79 GB عند اختيار Powerful |
| النموذج المستخدم | Qwen3.5 4B | ظهر داخل التطبيق بعد الإعداد |
| فهم العربية | نجح | فهم أسئلة عربية وأجاب بالعربية |
| محادثة بدون إنترنت | نجحت | بعد تنزيل النموذج مسبقًا |
| وقت اختبار العربية | 54.2 ثانية | كما ظهر في التطبيق |
| وقت اختبار آخر | 52.1 ثانية | كما ظهر في التطبيق |
| لم ينجح بصورة مستقرة | ظهر Invalid vector schema في إحدى المحاولات | |
| الصور | لم أختبر الجودة | ظهر تنزيل إضافي 672.42 MB |
| واجهة عربية | لم أجدها | هذا لا يمنع المحادثة بالعربية |
أكثر شيء أعجبني في AnythingLLM
أكثر لحظة أقنعتني بالتجربة لم تكن شاشة التنزيل ولا عدد الخيارات. كانت بعد إيقاف الإنترنت وإرسال السؤال الجديد ورؤية Qwen3.5 4B يبدأ في تكوين الإجابة.
هذا يجعل فكرة Local AI ملموسة جدًا. النموذج ليس مجرد اسم تختاره من قائمة بينما كل العمل يحدث في مكان آخر؛ لديك نموذج تم تنزيله إلى الهاتف ويمكنه تنفيذ المحادثة النصية محليًا.
وأعجبني أيضًا أن العربية لم تكن مجرد قدرة هامشية. استطعت استخدام النموذج بالعربية بصورة طبيعية، وهذا يجعل التقنية أكثر فائدة للمستخدم العربي.
الأشياء التي لم تعجبني
أولًا: الحجم. 3.79 GB لتنزيل واحد ليس قليلًا.
ثانيًا: السرعة. أوقات تجاوزت 50 ثانية في الاختبارات التي سجلتها تعني أن التجربة ليست مناسبة لمن يريد ردودًا فورية طوال الوقت.
ثالثًا: المستندات. كنت متحمسًا لهذا الجزء تحديدًا، ولذلك كان ظهور Invalid vector schema مزعجًا. سأحتاج إلى إعادة اختبار الميزة في إصدار آخر قبل الحكم عليها.
رابعًا: الواجهة الإنجليزية. أنا استطعت استخدام التطبيق، لكن وجود واجهة عربية كان سيجعل البداية أسهل للمستخدم العربي الذي لا يريد التعامل مع مصطلحات مثل Model وAttach files وProvider.
هل AnythingLLM مناسب لكل هاتف أندرويد؟
لن أقول نعم؛ تشغيل نموذج محلي يعتمد على موارد الجهاز. وكلما كان النموذج أثقل زاد الضغط المحتمل على الذاكرة والمعالج والتخزين.
إذا كان هاتفك قديمًا أو متوسط الإمكانات، من المنطقي البدء بخيار أخف بدل اختيار Powerful مباشرة. قد تكون سرعة النموذج الأصغر أهم من الفرق في جودة الإجابة.
أما الحرارة واستهلاك البطارية، فلم أسجل لهما قياسات دقيقة بأداة متخصصة في هذه التجربة، لذلك لن أضع أرقامًا تخمينية. لاحظت أن تشغيل النموذج يستغرق وقتًا ويستخدم الجهاز محليًا، لكن أي مقارنة دقيقة للحرارة أو البطارية تحتاج إلى اختبار مستقل.
قبل أن تنزّل AnythingLLM: هذه الأشياء كنت أتمنى معرفتها
أولًا، وفر مساحة تخزين جيدة. لا تنظر فقط إلى حجم تطبيق AnythingLLM في المتجر؛ ملفات النموذج هي الجزء الكبير.
ثانيًا، استخدم Wi-Fi في أول إعداد إذا كانت باقة البيانات محدودة، لأن تنزيل عدة جيجابايت ليس بسيطًا.
ثالثًا، لا تنزل كل المكونات الإضافية في البداية. جرّب الدردشة أولًا. إذا كانت التجربة مناسبة لجهازك، أضف الرؤية أو الميزات الأخرى لاحقًا.
رابعًا، لا تفترض أن كل ما يقوله النموذج صحيح لمجرد أنه يعمل محليًا. Local AI يغير مكان تشغيل النموذج، لكنه لا يلغي مشكلة الهلوسة أو الأخطاء.
وأخيرًا، إذا كان هدفك الرئيسي الخصوصية، انتبه إلى الأدوات التي تربطها بالنموذج. هناك فرق بين محادثة محلية خالصة وبين تشغيل ميزة تتصل بخدمة خارجية.
هل أنصح باستخدام AnythingLLM بدل ChatGPT أو Gemini؟
لا أتعامل معه كاستبدال مباشر. الاستخدامان مختلفان.
إذا أردت نموذجًا قويًا جدًا، بحثًا حديثًا على الإنترنت، أو استجابة أسرع، فالخدمات السحابية لها مزايا واضحة. أما إذا كنت تريد نموذجًا موجودًا على هاتفك ويمكن استخدامه في محادثة محلية بدون اتصال، فهنا يصبح AnythingLLM مثيرًا للاهتمام.
بالنسبة لي، أفضل سيناريو ليس اختيار أحدهما وحذف الآخر، بل استخدام المحلي عندما تكون ميزاته مناسبة واستخدام السحابي عندما أحتاج إلى قدراته.
وإذا كنت تفضل استخدام الذكاء الاصطناعي السحابي، فقد اختبرت أيضًا تحديث ChatGPT الجديد وميزة Intelligent UI، التي تتيح إنشاء حاسبات ومخططات تفاعلية داخل المحادثة. وهي تجربة مختلفة عن تشغيل نموذج محلي بدون إنترنت، وتوضح كيف تتطور أدوات الذكاء الاصطناعي في اتجاهين مختلفين.
أسئلة شائعة
هل AnythingLLM يعمل بدون إنترنت على أندرويد؟
نعم بالنسبة للمحادثة النصية المحلية التي اختبرتها. بعد تنزيل Qwen3.5 4B، قطعت الاتصال بالإنترنت وأرسلت سؤالًا جديدًا، واستطاع النموذج الإجابة. لا يعني ذلك أن كل ميزة داخل التطبيق تعمل Offline.
هل Qwen3.5 4B يدعم اللغة العربية؟
نعم في تجربتي. فهم الأسئلة المكتوبة بالعربية وأنتج إجابات عربية مفهومة ومنظمة. لكن المعلومات المهمة تظل بحاجة إلى التحقق من مصادر مستقلة.
كم حجم Qwen3.5 4B في AnythingLLM؟
عند اختياري Powerful، ظهر لي تنزيل بحجم 3.79 GB. قد تتغير الملفات أو الخيارات مع تحديثات التطبيق، لذلك هذا الرقم يصف التجربة التي أجريتها وليس حجمًا مضمونًا لكل إصدار.
هل AnythingLLM يقرأ ملفات PDF؟
التطبيق يوفر التعامل مع الملفات والمستندات، لكن تجربة PDF الخاصة بي لم تعمل بصورة مستقرة. ظهر خطأ Invalid vector schema في إحدى المحاولات، ولم أتمكن من إثبات نجاح استخراج المعلومات من الملف في الاختبار الذي أجريته.
ما معنى Invalid vector schema في AnythingLLM؟
ظهر الخطأ لدي أثناء محاولة معالجة ملف PDF. يرتبط النص نفسه بمرحلة البيانات المتجهية المستخدمة في البحث داخل المحتوى، لكنني لم أحدد سبب المشكلة على جهازي بصورة قاطعة. لذلك لم أضع حلًا غير مجرب للمشكلة.
هل AnythingLLM يدعم الصور؟
ظهرت لدي خيارات اختيار صورة من المعرض والتقاط صورة، لكن التطبيق طلب تنزيلًا إضافيًا بحجم 672.42 MB لدعم الرؤية. لم أنزل المكون في هذه الجولة، لذلك لم أختبر جودة تحليل الصور بعد.
هل AnythingLLM له واجهة عربية؟
لم أجد واجهة عربية في الإصدار الذي اختبرته. كانت القوائم بالإنجليزية، لكن Qwen3.5 4B نفسه استطاع المحادثة باللغة العربية.
هل الذكاء الاصطناعي المحلي أكثر خصوصية؟
تشغيل الاستدلال على الجهاز يقلل الحاجة إلى إرسال طلب المحادثة إلى نموذج سحابي. لكن أي أدوات أو مزودات أو خدمات خارجية تقوم بتفعيلها قد تغير ذلك، لذلك لا ينبغي اعتبار كل نشاط داخل التطبيق محليًا تلقائيًا.
هل أستطيع استخدام AnythingLLM أثناء السفر بدون إنترنت؟
بالنسبة للمحادثة النصية المحلية، هذا أحد الاستخدامات المنطقية. يجب تنزيل النموذج وتجهيزه مسبقًا قبل فقد الاتصال، وأي وظيفة تعتمد على الويب لن تعمل دون شبكة.
هل النموذج المحلي سريع؟
ليس بالضرورة. في تجربتي استغرق اختباران حوالي 54.2 و52.1 ثانية. أجهزة أخرى ونماذج أخرى قد تعطي نتائج مختلفة، لذلك لا أعتبر هذه الأرقام معيار أداء عامًا.
هل أحتاج إلى تنزيل 3.79 GB في كل مرة؟
لا، التنزيل كان للحصول على ملفات النموذج محليًا. الفكرة أن يبقى النموذج على الجهاز بعد تنزيله، ما لم تحذفه أو تغير النموذج أو تتطلب نسخة جديدة تنزيلًا آخر.
الخلاصة بعد التجربة الفعلية
دخلت هذه التجربة وأنا متشكك قليلًا في مدى فائدة تشغيل نموذج لغوي كامل على الهاتف. بعد استخدامها، أكثر شيء تغير في رأيي هو أن الذكاء الاصطناعي المحلي على أندرويد لم يعد بالنسبة لي مجرد فكرة للمطورين والهواة.
Qwen3.5 4B استطاع فهم العربية وتوليد إجابة جديدة بعد فصل الإنترنت. هذه النتيجة وحدها تجعل AnythingLLM تجربة مثيرة لمن يريد Local AI على هاتفه.
لكن توجد حدود واضحة. النموذج احتاج تنزيلًا بحجم 3.79 GB، والردود التي قستها استغرقت أكثر من 50 ثانية، واختبار PDF لم يعمل كما كنت أتمنى.
وهذا هو سبب أنني لا أصف التطبيق بأنه ممتاز في كل شيء. الجزء الذي نجح معي سأقول إنه نجح، والجزء الذي فشل سأترك صورته ونتيجته هنا. إذا أصلح تحديث لاحق مشكلة المستندات أو تغير أداء النموذج، سأعيد الاختبار وأحدّث النتائج.
بالنسبة لي، السؤال لم يعد: «هل يمكن تشغيل AI على هاتف أندرويد بدون إنترنت؟» لأنني اختبرت ذلك بالفعل. السؤال الأكثر إثارة الآن هو: إلى أي مدى ستقترب هذه النماذج المحلية الصغيرة من تجربة النماذج السحابية خلال الفترة القادمة؟
عن التجربة: النتائج والصور وأوقات التنفيذ الواردة في هذا المقال مبنية على الاختبار العملي الذي أجريته أثناء إعداد المقال. قد تختلف السرعة والنتائج باختلاف الهاتف وإصدار AnythingLLM والنموذج والإعدادات.